
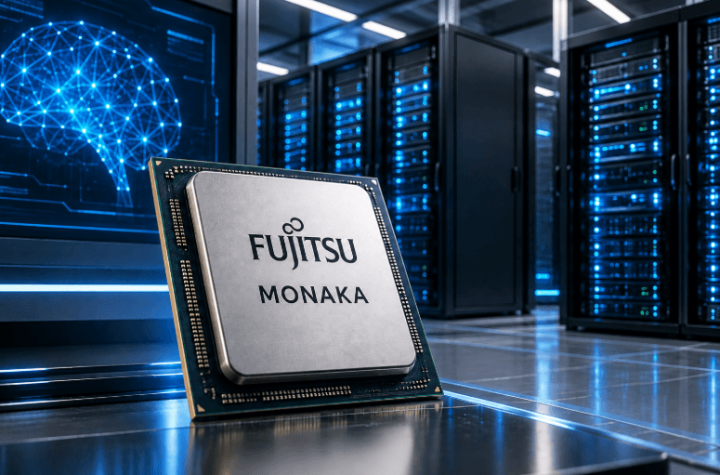
Fujitsu mulai membawa prosesor MONAKA dari tahap pengembangan menuju produk komersial. Perusahaan teknologi asal Jepang itu menyiapkan FUJITSU-MONAKA untuk pasar global, sekaligus memperkenalkan keluarga server berbasis prosesor tersebut yang difokuskan pada inferensi kecerdasan buatan (AI), komputasi performa tinggi (HPC), dan infrastruktur berdaulat.
MONAKA mengusung pendekatan teknis yang cukup berbeda. Fujitsu memadukan area inti CPU yang diproduksi dengan teknologi fabrikasi 2 nanometer dengan komponen cache dan I/O berbasis proses 5 nanometer. Seluruh bagian tersebut kemudian dihubungkan melalui teknologi 3D Stacking. Prosesor ini dirancang mencapai kecepatan hingga 3,8 GHz serta mendukung memori hingga 8.800 MT/s.
Arsitektur 2 Nm dan 5 Nm dalam Satu Prosesor
Alih-alih memproduksi seluruh bagian prosesor menggunakan node fabrikasi yang sama, Fujitsu membagi fungsi MONAKA ke beberapa teknologi proses. Inti CPU menggunakan fabrikasi 2 nm, sementara cache dan komponen I/O dibuat dengan teknologi 5 nm.
Pendekatan ini masuk akal dari sisi biaya dan efisiensi produksi karena tidak semua bagian prosesor memperoleh manfaat yang sama dari transistor berukuran lebih kecil. Cache dan fungsi I/O, misalnya, umumnya tidak membutuhkan teknologi fabrikasi seagresif inti komputasi.
Teknologi 3D Stacking memungkinkan berbagai komponen tersebut tetap terhubung secara erat. Fujitsu juga memadukan desain ini dengan teknologi internal yang memungkinkan prosesor beroperasi pada tegangan relatif rendah.
Namun, sejauh ini belum tersedia pengukuran independen mengenai konsumsi daya MONAKA. Klaim terkait efisiensi energi masih berasal dari Fujitsu dan perlu diverifikasi melalui pengujian pihak ketiga.
MONAKA Dirancang untuk Inferensi AI
Fujitsu membekali MONAKA dengan dukungan Confidential Computing melalui Arm CCA. Teknologi tersebut ditujukan untuk melindungi data yang tersimpan di memori maupun sedang diproses, termasuk dari perangkat lunak dengan hak akses tinggi seperti sistem operasi atau hypervisor.
Instruksi Khusus untuk Operasi AI
MONAKA tidak hanya diposisikan sebagai CPU server konvensional. Prosesor ini memiliki instruksi khusus untuk mempercepat operasi matriks, sementara SVE2 digunakan untuk menangani perhitungan berbasis vektor.
Fujitsu menggabungkan kemampuan perangkat keras tersebut dengan optimalisasi perangkat lunak untuk meningkatkan kinerja inferensi AI. Perusahaan mengklaim MONAKA mampu memberikan performa inferensi AI hingga dua kali dibandingkan CPU lain.
Meski demikian, detail mengenai prosesor pembanding, model AI, serta konfigurasi pengujian yang mendasari klaim tersebut belum dijelaskan secara lengkap. Karena itu, angka tersebut masih harus dipandang sebagai klaim produsen hingga tersedia benchmark independen.
Pengujian menggunakan model bahasa, pemrosesan visual, dan beban kerja server nyata nantinya akan menjadi faktor penting untuk menilai kemampuan MONAKA.
Pendekatan berbasis CPU juga memiliki potensi tersendiri karena tidak semua aplikasi AI membutuhkan GPU. Model inferensi berukuran lebih kecil, agen AI, dan aplikasi perusahaan dapat memperoleh manfaat jika mampu berjalan langsung pada server CPU tanpa kartu akselerator tambahan.
Fujitsu Bangun Server Sendiri Berbasis MONAKA
Selain menawarkan CPU kepada penyedia cloud, pusat data, dan produsen server, Fujitsu juga menyiapkan sistem server berbasis MONAKA.
Perusahaan merancang server 2U dengan dua CPU serta varian 1U dengan konfigurasi satu atau dua prosesor. Server 1U turut mendukung CDI dan CXL, yang memungkinkan memori serta akselerator dikelola sebagai kumpulan sumber daya melampaui batas fisik satu server.
Kemampuan tersebut relevan untuk inferensi AI karena kebutuhan memori pada model berukuran besar dapat dengan cepat menjadi faktor pembatas.
Untuk kebutuhan HPC, Fujitsu juga menyiapkan konfigurasi multi-node 2U yang menggabungkan empat node, masing-masing dilengkapi dua prosesor. Beban kerja yang ditargetkan mencakup simulasi dan surrogate model.
Sistem tersebut diproduksi di fasilitas Kasashima milik Fujitsu di Jepang. Perusahaan memasukkan aspek produksi ini ke dalam strategi Sovereign AI, dengan tujuan meningkatkan transparansi mengenai asal komponen dan rantai manufaktur.
Pendinginan Udara hingga 40 Derajat Celsius
Fujitsu turut menyoroti sistem pendinginan sebagai salah satu pembeda dari infrastruktur AI yang banyak mengandalkan GPU. Server 1U dirancang tetap dapat beroperasi menggunakan pendinginan udara pada suhu lingkungan hingga 40 derajat Celsius.
Sebagai alternatif, sistem mendukung pendinginan air dengan suhu hingga 45 derajat Celsius. Fujitsu mengklaim teknologi tersebut dapat mengurangi energi yang diperlukan untuk pendinginan server hingga 80 persen.
Angka penghematan tersebut juga masih berasal dari pengujian atau pernyataan internal perusahaan sehingga membutuhkan evaluasi independen dalam penggunaan nyata.
Kebutuhan ini semakin relevan karena rak server AI modern cenderung memerlukan pasokan listrik dan infrastruktur pendinginan khusus. Fujitsu mencoba menangani sebagian kebutuhan inferensi AI melalui platform CPU yang dapat dioperasikan di pusat data dengan infrastruktur lebih konvensional.
MONAKA Menjadi Fondasi Platform Server Fujitsu
Fujitsu mengembangkan MONAKA bukan sekadar sebagai prosesor individual, tetapi sebagai fondasi bagi platform server miliknya. Perusahaan juga merencanakan varian berdensitas tinggi untuk pusat data AI serta sistem rak lengkap sebagai bagian dari pengembangan selanjutnya.
Strategi MONAKA menarik karena Fujitsu tidak berupaya membuat GPU baru. Sebaliknya, perusahaan mengandalkan CPU Arm generasi baru untuk membawa lebih banyak beban kerja inferensi AI kembali ke prosesor utama.
Kombinasi inti 2 nm, cache dan I/O 5 nm, serta teknologi 3D Stacking menunjukkan bagaimana CPU server modern semakin mengandalkan integrasi beberapa proses fabrikasi dan teknologi pengemasan. Meski demikian, klaim performa inferensi AI hingga dua kali lebih tinggi dan pengurangan kebutuhan energi pendinginan masih harus dibuktikan melalui pengujian independen.
Berita Lainnya
Raspberry Pi OS Terbaru Hadir dengan Dukungan Dok dan Alat Tangkapan Layar Baru
Chip Kirin Berbasis Hukum Tau Diklaim Huawei Mampu Mengurangi Masalah Panas Berlebih
Ulasan Xiaomi Redmi Note 17 Pro Max: Baterai 10.000 mAh Jadi Andalan